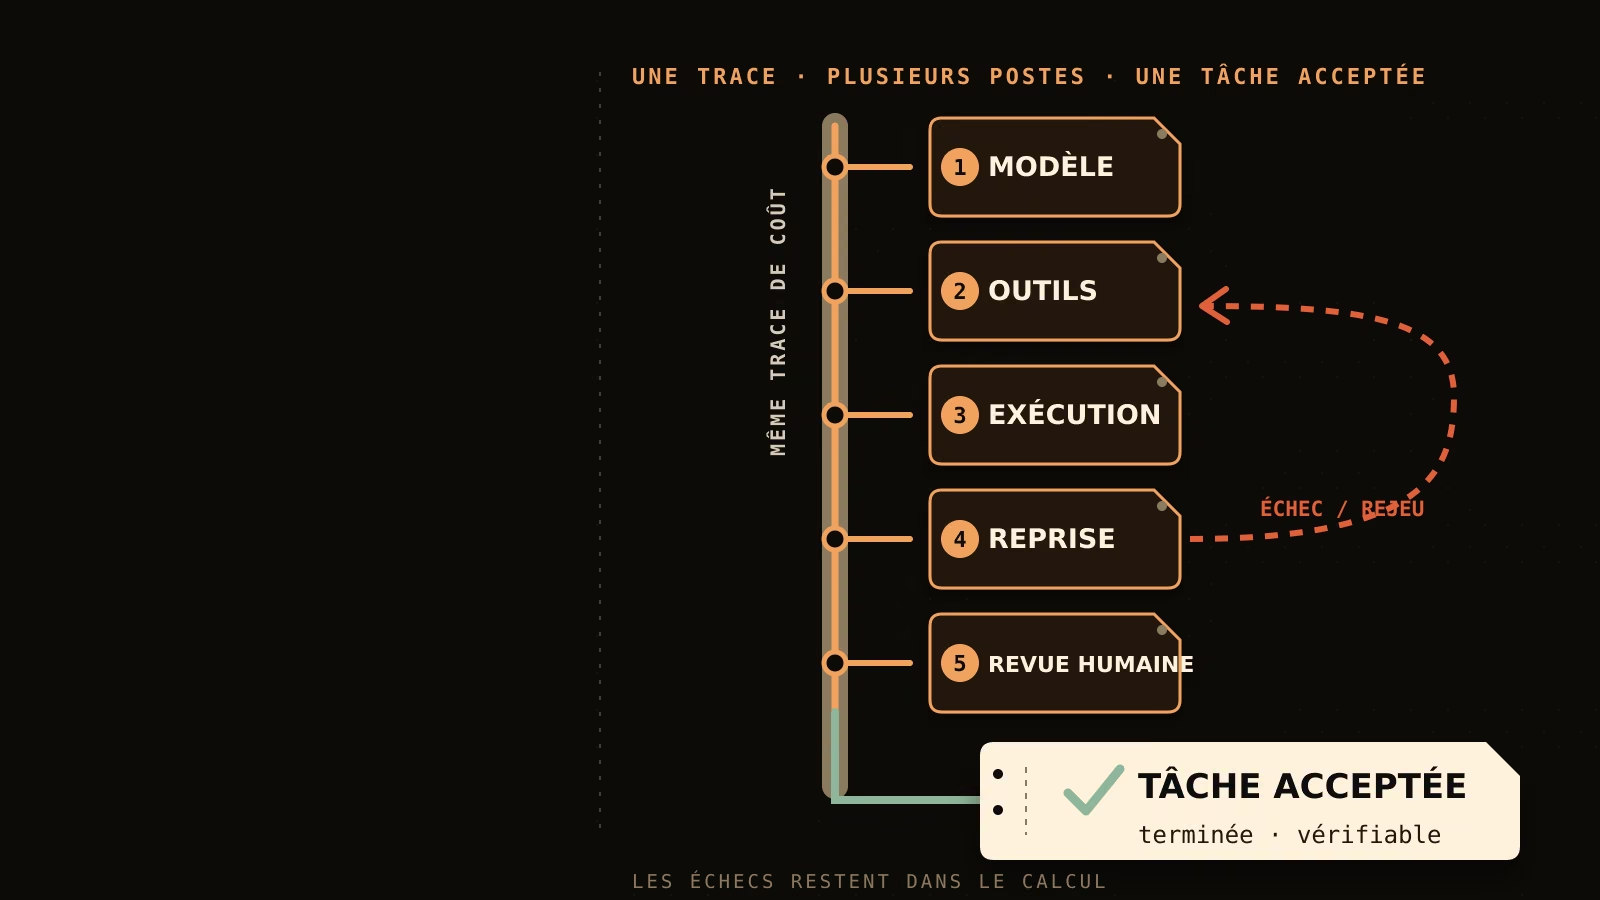
Il n’existe pas de prix universel pour un agent IA. Un budget défendable part d’un workflow borné et additionne trois couches : la mise en place, le coût mesuré d’une tâche terminée, puis l’exploitation et le contrôle. Une fourchette annoncée sans volume, nombre d’étapes, outils, taux d’échec ni temps humain ne permet pas de comparer deux projets.
Le bon point de départ n’est donc pas « combien coûte un million de tokens ? », mais « combien coûte une tâche métier acceptée ? ». Pour y répondre, faites exécuter un petit lot de cas représentatifs, attribuez chaque consommation au bon workflow, gardez les échecs et les reprises dans le calcul, puis rapprochez l’estimation des compteurs réellement facturés.
Le prix d’un agent IA n’est pas un seul compteur
Un agent peut lire une demande, interroger une base documentaire, appeler un outil métier, vérifier le résultat et demander une validation. La facture suit cette chaîne, pas l’étiquette « agent IA ».
Les pages officielles d’OpenAI et d’Anthropic séparent déjà plusieurs lignes : entrée et sortie du modèle, cache, outils ou fonctions facturées à part. Certains appels d’outils consomment aussi des tokens au tarif du modèle.[1][2] Compter uniquement les tokens de sortie laisse donc de côté une partie mesurable du run.
La structure change avec l’architecture choisie. Google distingue modèles, ancrage dans des sources et autres fonctions de sa plateforme.[3] Microsoft sépare notamment modèles, agents hébergés, outils et bases de connaissances.[4] AWS présente AgentCore comme un ensemble de capacités modulaires dont l’environnement d’exécution, la mémoire, le navigateur ou l’observabilité peuvent porter leurs propres compteurs ou coûts de ressources.[5] Ces documentations prouvent que les compteurs sont multiples. Elles ne comparent ni la qualité, ni le coût total des fournisseurs.
Pour établir un coût complet, séparez :
- la mise en place : cadrage du workflow, connexions, règles, tests et préparation du passage en exploitation ;
- la consommation variable : modèle, cache, outils, recherche, stockage, calcul, reprises et validation pour les tâches du lot ;
- l’exploitation et le contrôle : supervision, maintenance, licences, environnements, gestion des incidents et temps humain récurrent.
Un devis peut regrouper ces postes. Votre feuille de décision doit pouvoir les retrouver.
Commencer par une tâche terminée, pas par un million de tokens
Le dénominateur utile est une tâche métier terminée et acceptée. Pour un agent de boîte de réception, ce pourrait être une demande classée avec les champs attendus. Pour un agent documentaire, un dossier extrait et vérifié. Pour un agent CRM, une mise à jour préparée puis acceptée selon la règle prévue.
Définissez cette fin avant la mesure. Un run techniquement achevé ne compte pas comme tâche acceptée si le résultat est inutilisable, s’il manque un champ obligatoire ou si un humain doit tout refaire.
La formule reste simple :
Coût par tâche terminée = (coûts mesurés du lot + revue et reprise humaines allouées) / nombre de tâches acceptées et terminées
Les tentatives échouées, rejouées ou escaladées restent au numérateur. Les retirer ferait paraître le workflow moins cher précisément quand il se comporte mal. AWS recommande d’ailleurs d’attribuer les coûts au-delà du compte cloud, jusqu’au cycle de raisonnement, à l’agent, au workflow et à la tâche terminée.[8]
Cette mesure n’est pas un calcul de ROI. Elle répond à une question plus étroite : quel est le coût observé pour produire l’unité de travail que le métier accepte ? La valeur créée, le payback et les économies éventuelles demandent d’autres preuves.

Mesurer un petit lot représentatif
Ne lancez pas une estimation mensuelle à partir d’une seule démonstration réussie. Construisez un lot qui ressemble au trafic attendu, sans lui attribuer une taille universelle : cas normaux, entrées longues ou ambiguës, outil indisponible, document manquant, reprise et escalade humaine.
Pour chaque tâche, propagez un identifiant de workflow et notez seulement les champs nécessaires au coût :
- le statut final : acceptée, refusée, échouée ou reprise ;
- les appels modèle, avec entrée, sortie et cache distingués quand la facture le fait ;
- les outils et services appelés, y compris recherche documentaire, extraction, stockage ou connexion métier ;
- la durée d’exécution ou le calcul facturable ;
- les nouvelles tentatives, boucles arrêtées et escalades ;
- le temps de revue et de correction humaine ;
- l’environnement, le fournisseur, la région ou le niveau de service lorsque ces choix changent le compteur.
Ce n’est pas une checklist générale d’observabilité d’un agent IA. Ici, chaque champ doit servir l’attribution du coût. L’API de rapport de coûts d’Anthropic illustre ce niveau de détail avec des tranches temporelles et des dimensions telles que l’espace de travail, le modèle, le type de coût, le niveau de service ou le type de token.[7]
Microsoft propose une séquence utile pour valider un plan : estimer, produire un trafic de test représentatif, inspecter les compteurs réels, rapprocher l’écart, puis corriger la référence initiale avant le déploiement. Sa documentation rappelle aussi que les coûts de la plateforme ne couvrent pas nécessairement toute l’application.[9]
Faites donc deux rapprochements : trace d’exécution vers compteur d’usage, puis compteur d’usage vers facture. Si une ligne ne peut pas être reliée au workflow, marquez-la « non attribuée » au lieu de la répartir au jugé.
La feuille de coût en trois couches
La feuille peut rester courte. Chaque entrée a un propriétaire, une source vérifiable et une valeur à renseigner après le test. Laisser une cellule vide vaut mieux qu’un chiffre décoratif.
| Couche | Poste à renseigner | Unité ou méthode | Propriétaire | Source de preuve |
|---|---|---|---|---|
| Mise en place | Cadrage et critères d’acceptation | Temps ou montant du devis | Métier + livraison | Périmètre signé |
| Mise en place | Connexions, règles et tests | Temps ou montant du devis | Livraison | Devis et journal de travail |
| Variable | Modèle : entrée, sortie, cache | Compteurs du fournisseur | Technique | Rapport d’usage + facture |
| Variable | Outils, recherche documentaire, stockage | Appels, sessions ou ressources | Technique | Rapport du service |
| Variable | Exécution et calcul | Durée ou ressources facturées | Technique | Compteurs d’infrastructure |
| Variable | Échecs, reprises et escalades | Coût rattaché au même workflow | Exploitation | Trace + rapport d’usage |
| Variable | Revue et reprise humaine | Temps alloué au lot | Métier | Journal de revue |
| Récurrente | Supervision, maintenance, licences | Période contractuelle | Exploitation + achat | Contrat + facture |
| Récurrente | Environnements et continuité manuelle | Ressources et temps | Technique + métier | Inventaire + procédure |
Ajoutez la devise, la région, le niveau de traitement et la date de vérification dès qu’ils influencent la tarification. N’utilisez pas une page de prix comme si elle était la facture : les remises, engagements, taxes, conversions et services tiers peuvent modifier le montant réel.
Extrapoler au volume sans cacher l’incertitude
Une moyenne unique écrase les cas qui coûtent cher. Conservez plutôt la distribution observée dans le lot, puis construisez trois scénarios à partir de vos propres runs : bas, central et haut. Aucun de ces scénarios n’est une fourchette de marché.
Pour chacun, renseignez :
- le volume de tâches attendu ;
- la part de cas acceptés du premier coup ;
- la part de reprises, d’échecs et d’escalades ;
- le mix d’outils et de modèles réellement observé ;
- le temps humain alloué ;
- les postes fixes et récurrents ;
- la date de la grille tarifaire utilisée.
Le scénario haut ne doit pas être un nombre arbitraire ajouté « par prudence ». Il doit correspondre à une composition observée : davantage de documents longs, de recherches, de reprises ou de revues. Si le lot n’a pas couvert un cas, inscrivez l’incertitude au lieu d’inventer son coût.
Gardez enfin deux colonnes séparées : estimation et réel facturé. L’écart peut venir d’un changement de prix, d’un mauvais rattachement, d’un comportement différent du test ou d’un poste oublié. Cet écart est une information de pilotage, pas une anomalie à lisser.
Plafond, alerte et mode dégradé
Un budget a besoin de garde-fous, mais leurs effets doivent être nommés correctement. Une alerte de dépense prévient et laisse le trafic continuer. Une limite dure rejette les requêtes concernées lorsque le montant suivi atteint le plafond. Son application n’est pas instantanée et la dépense enregistrée peut légèrement dépasser la limite configurée.[6]
La limite dure protège un budget, pas la continuité de service. Si elle se déclenche au milieu d’un workflow, que devient la tâche ? Prévoyez avant le pilote :
- des limites d’itérations, de durée ou de consommation au niveau du workflow ;
- un arrêt qui marque la tâche comme incomplète au lieu de produire un faux succès ;
- une file manuelle pour les cas interrompus ;
- un propriétaire de l’alerte et de la décision de reprise ;
- un rapprochement entre tâches stoppées et coûts déjà engagés.
Le mode dégradé peut être simple : l’agent prépare sans exécuter, ou remet le dossier à un humain avec son état actuel. La procédure détaillée de réponse à incident reste un chantier séparé.
Les questions à poser avant un devis
Deux propositions ne sont comparables que si elles chiffrent la même unité et montrent ce qui reste dehors. Demandez :
- Quelle tâche terminée sert de dénominateur ?
- Quels modèles, outils, connexions, licences, stockages et environnements sont inclus ?
- Quels postes seront facturés directement par un fournisseur tiers ?
- Quelles hypothèses de volume, longueur d’entrée et mix de cas soutiennent l’estimation ?
- Comment les reprises, échecs, escalades et revues humaines sont-ils comptés ?
- Quels coûts relèvent de la mise en place, de l’usage ou de l’exploitation récurrente ?
- Comment un changement de prix ou de niveau de service met-il l’estimation à jour ?
- Pouvez-vous exporter l’usage et le rapprocher de la facture par workflow ?
- Que se passe-t-il quand une alerte ou une limite est atteinte ?
- Qui possède la référence initiale et valide l’écart entre estimation et réel ?
Le protocole d’évaluation avant production vous dira si les tâches sont acceptables. La feuille de coût dira ce qu’elles consomment. Ne mélangez pas les deux décisions.
Apportez un workflow, son volume et quelques cas réels : Last Word peut construire un budget testable avant de construire l’agent. Découvrez notre approche sur mesure, le service agent IA support, ou décrivez le workflow à cadrer.
Questions fréquentes
Combien coûte un agent IA ?
Il n’existe pas de montant universel. Le coût dépend du workflow, du volume, des modèles et outils appelés, des échecs, du temps humain et de l’exploitation. Mesurez un lot représentatif, calculez le coût par tâche acceptée et ajoutez mise en place et coûts récurrents.
Comment calculer le coût par tâche d’un agent IA ?
Additionnez les coûts mesurés du lot et la revue ou reprise humaine allouée, puis divisez par le nombre de tâches acceptées et terminées. Les runs échoués, rejoués ou escaladés restent au numérateur, car ils ont consommé des ressources.
Les tokens représentent-ils tout le coût d’un agent IA ?
Non. Selon l’architecture, la facture peut aussi inclure cache, outils, recherche, stockage, durée d’exécution, calcul, connexions, licences et contrôle humain.[1][2][3][4][5] Le détail doit venir des compteurs de l’architecture réellement testée.
Quels coûts faut-il ajouter au devis initial ?
Ajoutez les services tiers exclus, les environnements, la supervision, la maintenance, les licences, les reprises et la revue humaine. Demandez qui facture chaque ligne et comment elle sera rapprochée des usages réels.
Comment empêcher la facture d’un agent IA de déraper ?
Posez des limites au niveau du workflow, surveillez les compteurs et combinez alertes et plafond dur avec un mode dégradé. Une alerte ne bloque pas les appels ; un plafond dur peut interrompre le service et son application peut avoir un léger délai.[6]
Comment comparer deux offres d’agents IA ?
Ramenez-les à la même tâche terminée, au même volume et au même périmètre de coûts. Comparez les postes inclus, les hypothèses, le traitement des échecs, le temps humain, les coûts récurrents et l’accès aux rapports d’usage. Une fourchette globale sans ces éléments n’est pas comparable.
Sources
[1] https://developers.openai.com/api/docs/pricing — OpenAI, « Pricing », compteurs modèle, cache, outils et conteneurs, date de mise à jour non affichée, consulté le 9 septembre 2026.
[2] https://docs.anthropic.com/en/docs/about-claude/pricing — Anthropic, « Pricing », compteurs modèle, cache et fonctionnalités, date de mise à jour non affichée, consulté le 9 septembre 2026.
[3] https://cloud.google.com/vertex-ai/pricing — Google Cloud, « Vertex AI pricing », tarification des modèles, services et ressources de la plateforme, date de mise à jour non affichée, consulté le 9 septembre 2026.
[4] https://azure.microsoft.com/en-us/pricing/details/foundry-agent-service — Microsoft Azure, « Foundry Agent Service pricing », modèles, agents hébergés, outils et bases de connaissances, date de mise à jour non affichée, consulté le 9 septembre 2026.
[5] https://aws.amazon.com/bedrock/agentcore/pricing — AWS, « Amazon Bedrock AgentCore Pricing », capacités modulaires et ressources consommées, date de mise à jour non affichée, consulté le 9 septembre 2026.
[6] https://developers.openai.com/api/docs/guides/spend-limits — OpenAI, « Spend limits », distinction alerte / limite dure et délai d’application, date de mise à jour non affichée, consulté le 9 septembre 2026.
[7] https://platform.claude.com/docs/en/api/admin/cost_report/retrieve — Anthropic, « Get Cost Report », tranches temporelles et dimensions d’attribution, date de mise à jour non affichée, consulté le 9 septembre 2026.
[8] https://docs.aws.amazon.com/wellarchitected/latest/agentic-ai-lens/agentcost05.html — AWS Well-Architected, « Agent cost visibility and attribution », attribution jusqu’au workflow et à la tâche terminée, date de mise à jour non affichée, consulté le 9 septembre 2026.
[9] https://learn.microsoft.com/en-us/azure/foundry/concepts/manage-costs — Microsoft Learn, « Plan and manage costs for Microsoft Foundry », estimation, trafic de test et rapprochement des compteurs, date de mise à jour non affichée, consulté le 9 septembre 2026.