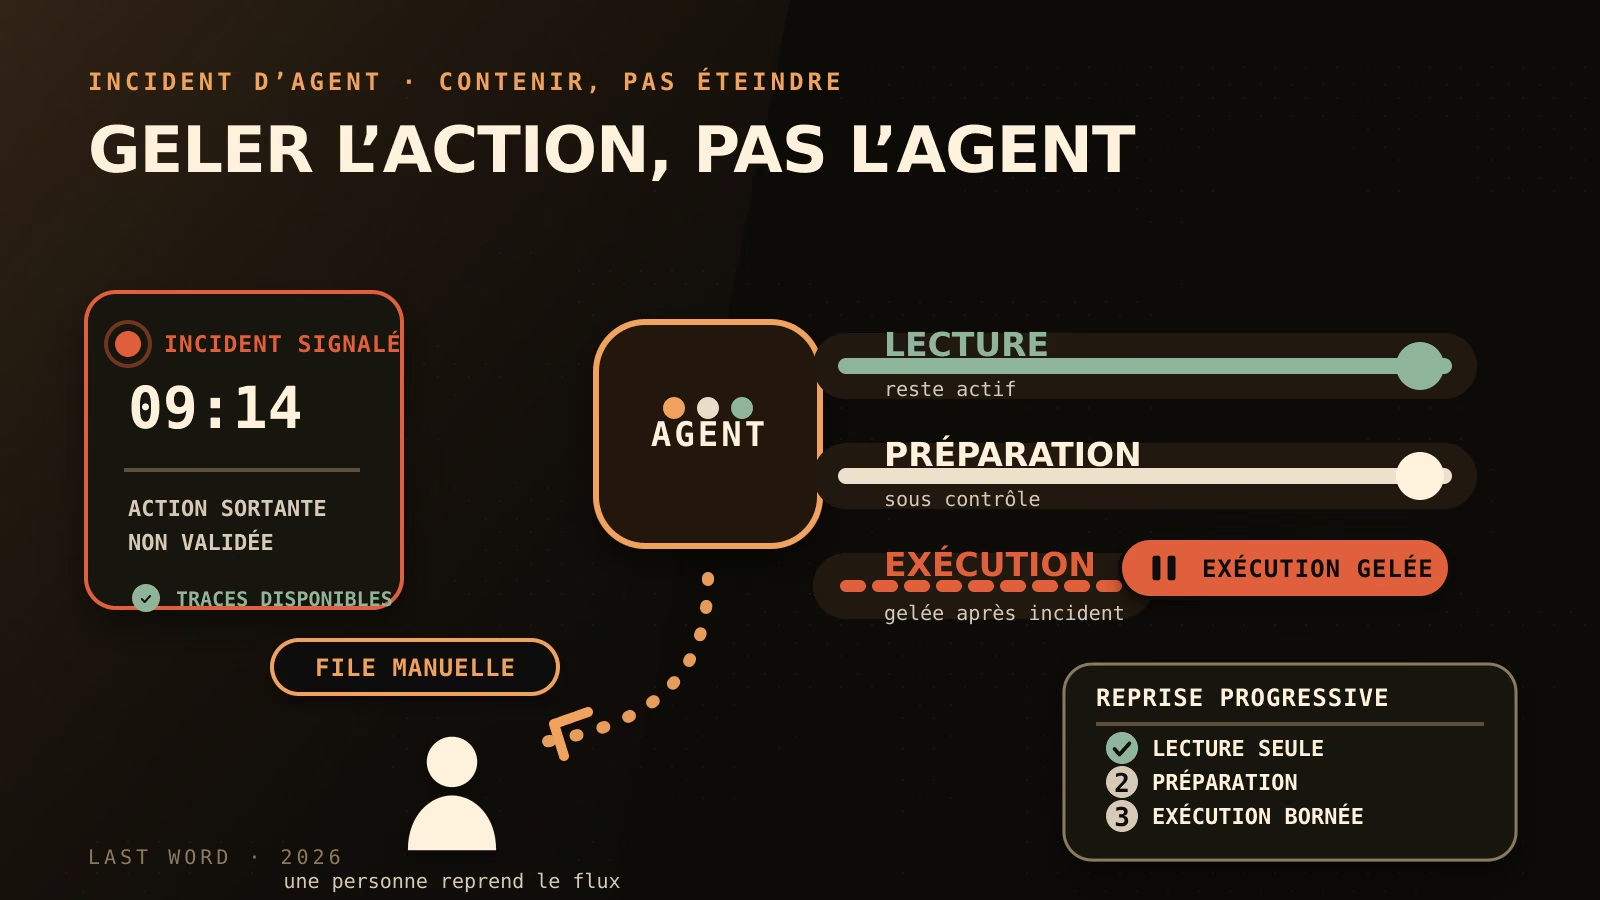
Un incident d’agent IA, c’est le moment où un agent en service produit une action fausse, trop large ou non sollicitée — alors même qu’il fonctionne techniquement. Il répond, il appelle ses outils, il se dit disponible. Et quelque part dans l’entreprise, un enregistrement a été modifié de travers, un email est parti en brouillon finalisé, un rapport est arrivé au mauvais destinataire.
La réponse ne commence ni par « tout éteindre », ni par « attendre de comprendre ». Elle commence par une séquence courte : contenir le périmètre de l’agent, qualifier ce qui s’est réellement passé avec les traces, reprendre le processus en manuel, corriger la cause, puis rétablir l’autonomie par paliers. Cet article détaille cette séquence, heure par heure, pour un décideur de PME qui n’a pas d’équipe platform dédiée.
Un incident d’agent ne ressemble pas à une panne
Une panne classique se voit : le service ne répond plus. Un incident d’agent est plus sournois, parce que l’agent reste disponible et continue de produire des effets en apparence normaux. Les runbooks d’exploitation décrivent précisément ce profil : mauvais outil appelé, action préparée sur un périmètre trop large, contournement d’une validation, boucle coûteuse, dérive de qualité après un changement de modèle ou de prompt.[1][2]
Exemples fictifs, mais typiques :
- un agent de classement range un quart des demandes entrantes dans la mauvaise catégorie après qu’une source a changé de format ;
- un agent de mise à jour de fiches modifie un champ sur l’ensemble d’un dossier au lieu d’une seule fiche, parce que le filtre était trop large ;
- un agent de rédaction envoie un brouillon d’email finalisé à un destinataire externe, alors que sa consigne était de préparer sans envoyer ;
- un agent de reporting relance la même extraction en boucle et alimente un rapport avec des doublons.
Dans les quatre cas, l’agent n’est « en panne » nulle part. C’est pourtant un incident opérationnel : des données fausses existent, des personnes ont vu des choses qu’elles n’auraient pas dû voir, et la confiance dans l’automatisation vient de prendre un coup.
C’est pour cela que le réflexe « tout couper » coûte cher : il détruit la valeur de tout ce que l’agent faisait correctement, sans pour autant annuler ce qui a déjà été produit. Et le réflexe inverse — attendre d’avoir tout compris avant d’agir — laisse l’agent continuer à produire des effets dans le même défaut. La bonne réponse tient entre les deux : réduire le périmètre, tout de suite, sans éteindre l’ensemble.
La décision des premières heures
Contenir sans tout couper, qualifier avec les traces, reprendre en manuel, corriger, puis rétablir progressivement. C’est l’ordre. L’inverser — corriger avant d’avoir qualifié, ou rétablir avant d’avoir corrigé — refait le même incident.
Les trente premières minutes : contenir, pas éteindre
Contenir, c’est réduire ce que l’agent peut faire, pas le supprimer. Trois mouvements suffisent, dans cet ordre :
- Retirer l’outil concerné. Si l’incident vient de l’outil d’envoi d’emails, on retire cet outil de l’agent, pas l’agent du système. Le classement, la lecture, la préparation continuent.
- Repasser en lecture seule. Quand l’origine exacte n’est pas encore connue, l’agent garde le droit de lire et d’analyser, perd le droit de modifier. C’est la dégradation contrôlée décrite par les runbooks d’exploitation : l’agent reste utile en assistance, les capacités sensibles sont réduites.[2]
- Geler les actions sortantes. Envoyer, publier, payer, créer, supprimer : tout ce qui produit un effet vers l’extérieur est suspendu jusqu’à la qualification.
En parallèle, on délimite le périmètre de dommage — ce que la littérature d’incident response appelle le blast radius : quels enregistrements ont été touchés, quels destinataires ont reçu quoi, sur quelle période, avec quel coût éventuel. Cette délimitation se fait avec les traces existantes, pas au ressenti. Si l’agent n’a pas de traces exploitables, notez-le : c’est une dette à régler après, et l’observabilité d’un agent IA mérite alors son propre chantier — cet article part du principe que des traces existent.
Une précaution immédiate : ne supprimez rien. Les enregistrements mal modifiés, les emails partis, les logs bruts sont vos preuves. L’archivage précède le nettoyage.
Qualifier avant de corriger
Une fois l’agent contenu, la question n’est plus « comment réparer » mais « que s’est-il passé, exactement ». Les runbooks AgentOps le posent en règle : diagnostiquer l’action avant tout rollback, en reconstituant la chaîne complète — quelle source a été utilisée, quel outil a été appelé, avec quelle identité, dans quel périmètre, avec quels paramètres, et quelle validation était attendue.[2]
Reconstituez cette chaîne de bout en bout, par événement :
- la source : quelle donnée l’agent a-t-il lue ? Était-elle à jour, complète, au format attendu ?
- la décision : qu’a-t-il conclu, et sur quelle base ?
- l’outil : le bon outil a-t-il été appelé, ou un outil de contournement ?
- les paramètres : le filtre, le destinataire, le périmètre étaient-ils conformes à la consigne ?
- l’identité et les droits : l’agent agissait avec quels droits ? Étaient-ils justifiés pour cette tâche ?
- la validation : une revue humaine était-elle prévue ? A-t-elle été contournée, ou l’agent avait-il le droit de passer seul ?
De cette chaîne sort une classification, et c’est elle qui détermine la réponse — pas l’intuition. Un playbook de recovery est explicite sur ce point : un rollback de prompt ne corrige pas un outil sur-permissionné ; un rollback de modèle ne corrige pas une source obsolète ; un redémarrage ne corrige pas un contournement de validation.[1] Traiter la mauvaise couche laisse la cause vivante, et l’incident reviendra.
Deux pièges classiques de qualification :
- la réponse fluide n’est pas une preuve de succès. Un agent peut confirmer une action de façon convaincante alors que l’effet réel est différent de l’effet annoncé ; la trace fait foi, pas le ton ;[1]
- l’absence de retour d’erreur n’est pas une preuve d’échec. Une action peut avoir été commise alors que l’agent n’a jamais reçu la confirmation — rejouer aveuglément crée des doublons.[1]
Reprendre le processus en manuel sans perdre le fil
Pendant que l’agent est contenu, le processus métier, lui, continue : les demandes entrantes arrivent, les dossiers s’accumulent. La reprise manuelle doit être organisée, pas improvisée.
Le mécanisme est une file d’attente humaine : tout ce que l’agent ne traite plus entre dans une file explicite, avec un responsable nommé et un ordre de traitement. Trois règles la tiennent propre :
- Conserver les entrées. Les demandes arrivent toujours au même endroit ; rien ne se perd pendant l’incident.
- Distinguer le terminé de l’en instance. Dressez la liste de ce que l’agent a réellement terminé avant containment — trace à l’appui — et de ce qui est resté à moitié fait. Un dossier à moitié traité est plus dangereux qu’un dossier non traité.
- Ne pas rejouer aveuglément. À la reprise, vérifiez l’état réel de chaque élément avant de le traiter : l’action annoncée a-t-elle eu lieu ? Le risque de doublon — refaire ce qui a déjà été fait, parce que la confirmation manque — est documenté comme un des pièges centraux de la reprise.[1]
Le placement du contrôle humain dans le workflow, en temps normal, mérite sa propre réflexion : cet article sur la validation humaine y est consacré. En incident, on applique la version d’urgence : tout passe par un humain, temporairement.
Annuler, compenser ou assumer
Une fois le dommage délimité, il faut traiter les effets déjà produits. Trois familles, et le tri change tout :
- Réversible : l’effet peut être restauré directement. La fiche modifiée à tort retrouve sa valeur d’origine, le classement erroné est refait. On restaure, on vérifie, on archive la preuve.
- Compensable : l’effet ne s’annule pas, mais une action explicite le neutralise. L’email parti au mauvais destinataire ne se rappelle pas : on envoie un correctif nommé, on prévient, on consigne. C’est le mécanisme que le pattern Saga formalise en architecture distribuée — quand une étape échoue ou sort du cadre, une transaction de compensation annule l’effet des étapes déjà commises ; certaines opérations y sont marquées compensables, d’autres forment des pivots irréversibles, d’autres sont simplement réessayables.[4]
- Irréversible : l’effet est définitif. On l’assume : prévenir les personnes touchées, documenter ce qui a été vu ou envoyé, corriger la cause pour que ça ne se reproduise pas.
Le réflexe à perdre : croire qu’il existe un « undo » global. Il n’existe pas. Ce qui existe, c’est une action corrective explicite — envoyée par un humain, assumée, tracée. Le tri réversible / compensable / irréversible se fait enregistrement par enregistrement, pas au global ; un même incident peut mélanger les trois.
Corriger la vraie cause
La correction vise la couche identifiée pendant la qualification — et elle seule, d’abord :
- source obsolète ou changée : reconnecter la bonne source, borner ce que l’agent peut en déduire ;
- outil erroné ou sur-permissionné : retirer ou restreindre l’outil, réduire les droits au minimum nécessaire à la tâche ;
- paramètre trop large : resserrer le filtre, le périmètre, la liste de destinataires ;
- consigne ambiguë : réécrire la consigne pour le cas qui a échoué, et pour ses cousins ;
- version de modèle ou de prompt régressive : revenir à la version précédente — ce qui suppose qu’elle existe.
C’est le point dur : on ne peut pas revenir en arrière sur ce qu’on n’a pas versionné. Prompts, consignes, outils exposés, permissions, versions de modèle doivent être versionnés pour qu’un retour arrière ciblé soit possible.[1][3] Si votre agent n’a aucun historique de versions, la correction sera artisanale — faisable, mais lente, et l’incident suivant se corrigera tout aussi lentement.
Un test de non-régression doit suivre la correction : rejouer le cas qui a échoué, en version fictive, et vérifier que le défaut a disparu sans en créer d’autres. C’est exactement ce que fait un protocole d’évaluation avant production — la différence est qu’ici, le cas de test vient de l’incident réel, désidentifié.
Un correctif superficiel — redémarrer, « resserrer un peu » sans identifier la couche fautive — laisse la cause vivante. La classification faite à la qualification est votre garantie de corriger la bonne chose.
Rétablir l’autonomie progressivement
La question qui arrive toujours trop vite : « on peut le rallumer ? » La réponse honnête est par paliers, et fondée sur des preuves, pas sur la confiance retrouvée. Les runbooks qui ont traversé ce moment décrivent la même progression :
- Lecture seule. L’agent relit, reclasse à blanc, prépare des propositions sans aucun droit d’écriture. On compare ses propositions avec ce que la file manuelle a produit.
- Préparation. L’agent prépare les actions — brouillons, mises à jour proposées — mais rien ne sort sans validation humaine.
- Exécution bornée. L’agent exécute, sur un périmètre réduit et pour des actions réversibles d’abord. Le périmètre se ré-élargit quand les preuves s’accumulent, pas quand l’équipe se sent rassurée.[2]
Les critères de ré-élargissement s’écrivent avant la réactivation : combien de cas traités à blanc sans écart, quelles familles d’erreurs observées, qui signe l’élargissement suivant. Sans critères écrits, la décision se prend dans la fatigue, juste après un lundi matin chargé — c’est comme ça que les seconds incidents arrivent.
Transformer l’incident en garde-fou durable
Un incident contient une leçon gratuite : il vous a montré un défaut que aucune démo n’aurait révélé. Trois conversions valent plus que tout post-mortem décoratif :
- la leçon devient un test. Le cas réel, désidentifié, entre dans la bibliothèque de cas de non-régression. La prochaine version de l’agent sera jugée dessus ;
- le symptôme devient une alerte. Ce qui vous a permis de détecter l’incident — un utilisateur, un contrôle a posteriori, un hasard — devrait désormais se voir automatiquement. Ce travail d’instrumentation appartient à l’observabilité de l’agent ;
- la cause devient une permission retirée. Si l’incident n’a été possible que parce que l’agent avait un droit dont il n’avait pas besoin, ce droit ne revient pas. La validation humaine se replace au bon endroit du workflow pour cette famille d’actions.
Si l’incident trouve son origine dans un contenu externe porteur d’instructions — un email, une page, un document qui a détourné la consigne de l’agent — la famille de risques est celle de l’injection de prompt indirecte, et la correction se joue aussi côté droits et sources, pas seulement côté consigne.
Gartner prédit que plus de 40 % des projets d’IA agentique seront abandonnés d’ici fin 2027, en citant les coûts qui montent, la valeur floue et les contrôles de risque insuffisants.[5] Ce chiffre n’est pas une preuve d’incidents — c’est un contexte de vigilance : les projets qui survivent seront ceux qui savent quoi faire quand ça dérape, pas ceux qui espèrent que ça ne déridera pas.
Le plan de repli à une page, écrit avant
Tout ce qui précède se prépare. La version opérationnelle tient sur une page, et s’écrit avant l’incident — pas pendant :

- qui peut arrêter quoi. Pour chaque agent : qui a le droit de retirer un outil, de repasser en lecture seule, de geler les sorties. Des personnes nommées, pas des rôles vagues ;
- qui reprend quoi en manuel. Quelle file, quel responsable, avec quel rythme de traitement ;
- comment on prévient. Qui prévient les personnes touchées — internes, clients, partenaires — et avec quel message ;
- quand on ré-élargit. Les critères de passage lecture seule → préparation → exécution bornée, et qui signe chaque palier ;
- où sont les versions. Où retrouver le prompt, la consigne, la liste d’outils, les droits en vigueur à la date de l’incident.
Une page. Si le plan de repli fait dix pages, il ne sera pas ouvert pendant l’incident.
Checklist : les questions à poser avant de déployer un agent
Si un prestataire vous propose un agent, ou si vous évaluez le vôtre, ces questions révèlent en avance la qualité de vos futures premières heures :
- Versionnement : prompts, consignes, outils et permissions sont-ils versionnés, avec un retour arrière ciblé possible ?
- Droits minimaux : l’agent a-t-il exactement les droits nécessaires à la tâche — et pouvez-vous en retirer un sans tout casser ?
- Traces exploitables : après une action fausse, saurez-vous reconstituer source, outil, paramètres, identité et validation ?
- Reprise manuelle : existe-t-il une file d’attente humaine prête à prendre le relais, avec un responsable nommé ?
- Compensation : pour chaque action sortante, est-elle réversible, compensable ou irréversible — et qui décide de la compensation ?
- Rétablissement : les paliers lecture seule → préparation → exécution bornée sont-ils définis, avec des critères de ré-élargissement écrits ?
Un prestataire sérieux répond précisément, ou construit ces réponses avec vous. Celui qui vous dit que son agent ne fait pas d’erreurs vous prépare un incident sans plan.
Un agent IA en service a produit une action fausse ou trop large ? Last Word peut vous aider à contenir, qualifier, reprendre en manuel puis rétablir un périmètre d’autonomie justifié — et à écrire le plan de repli avant le prochain incident. Consultez le service agent IA support, voyez comment nous fiabilisons l’automatisation de vos processus, ou décrivez votre situation.
Questions fréquentes
Que faire immédiatement quand un agent IA produit une action fausse en production ?
Contenir sans tout éteindre : retirer l’outil concerné, repasser l’agent en lecture seule, geler les actions sortantes, puis délimiter le périmètre de dommage avec les traces. La coupure totale détruit la valeur de ce que l’agent faisait correctement sans annuler les effets déjà produits ; l’inaction laisse le défaut se répéter.[2]
Faut-il arrêter complètement un agent IA après un incident ?
Non, sauf preuve que le défaut touche l’ensemble de ses actions. La réponse graduée — lecture seule, préparation, exécution bornée — conserve l’assistance utile de l’agent pendant que les capacités sensibles sont réduites, validées puis réactivées sur preuves.[2]
Comment annuler l’action fausse d’un agent IA ?
On ne l’annule pas globalement : on trie. Les effets réversibles se restaurent, les effets compensables se neutralisent par une action corrective explicite — le mécanisme formalisé par le pattern Saga[4] — et les effets irréversibles s’assument : prévenir, documenter, corriger la cause. Il n’existe pas d’« undo » magique.
Pourquoi le rollback ne suffit pas à corriger un incident d’agent ?
Parce que la couche fautive détermine la réponse : un rollback de prompt ne corrige pas un outil sur-permissionné, un rollback de modèle ne corrige pas une source obsolète, un redémarrage ne corrige pas un contournement de validation.[1] Sans classification préalable, on corrige la mauvaise couche et la cause reste vivante. Et sans versionnement des prompts et droits, aucun retour arrière ciblé n’est possible.[1][3]
Comment éviter que l’incident se reproduise ?
En convertissant l’incident en garde-fous : le cas réel devient un test de non-régression, le symptôme devient une alerte, la cause devient un droit retiré ou une validation replacée dans le workflow. Les critères de ré-élargissement d’autonomie s’écrivent avant la réactivation — par paliers, sur preuves, pas sur la confiance retrouvée.[2]
Sources
[1] https://midpoint.ai/post/ai-agent-failure-recovery-playbook — Midpoint, « AI Agent Failure Recovery Playbook », publié le 21 août (2026), consulté le 4 septembre 2026.
[2] https://naxaya.com/fr/articles/agentops-diagnostiquer-action-agent-ia-avant-rollback/ — Naxaya, « AgentOps : diagnostiquer une action d’agent IA avant rollback », publié le 22 juin 2026, consulté le 4 septembre 2026.
[3] https://gravity.fast/blog/how-to-handle-agent-errors-gracefully/ — Gravity, « How to Handle AI Agent Errors Gracefully », publié le 9 juin 2026, consulté le 4 septembre 2026.
[4] https://learn.microsoft.com/en-us/azure/architecture/patterns/saga — Microsoft Learn, Azure Architecture Center, « Saga distributed transactions pattern », date de publication non affichée, consulté le 4 septembre 2026.
[5] https://www.gartner.com/en/newsroom/press-releases/2025-06-25-gartner-predicts-over-40-percent-of-agentic-ai-projects-will-be-canceled-by-end-of-2027 — Gartner, communiqué du 25 juin 2025, consulté le 4 septembre 2026.