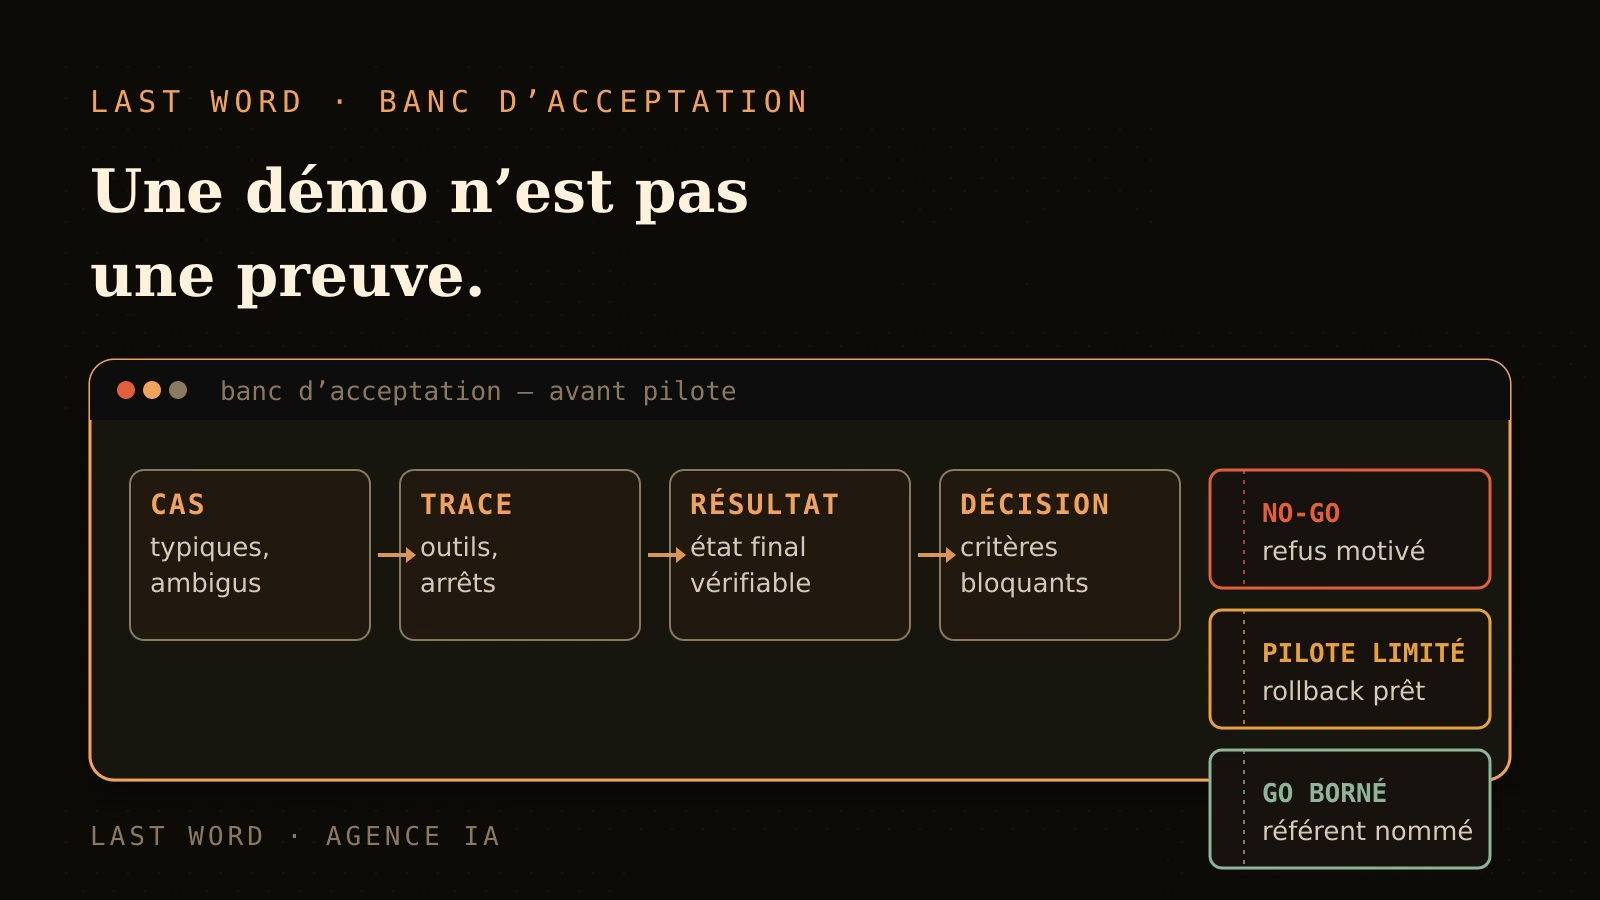
La démo montre ce qu’un agent IA peut faire un bon jour, sur un cas choisi. La question de mise en production est différente : quelles preuves existent pour affirmer que cet agent produit un résultat vérifiable, encore et encore, sur vos cas réels — et qu’il s’arrête proprement quand il ne sait pas ?
La démo ne répond pas à cette question. Elle démontre une possibilité, pas une preuve répétable. Toute la décision de mise en pilote se joue entre les deux.
L’évaluation d’un agent IA, c’est l’ensemble des tests et critères d’acceptation qui transforment cette question métier en vérification organisée : des cas représentatifs, un résultat attendu par cas, des actions interdites, des traces observables et une décision explicite à la fin.
Pourquoi la démo ne prouve rien pour la release
Un prototype d’agent convainc parce qu’il est montré dans sa configuration favorable : la question est claire, la donnée est propre, l’outil répond. Anthropic décrit ce décalage en expliquant que les capacités qui rendent les agents utiles — autonomie, appels d’outils, adaptation en cours de tâche — sont précisément celles qui les rendent difficiles à évaluer, et que les stratégies qui tiennent en déploiement réel combinent plusieurs familles de tests plutôt qu’un score unique.[1]
Concrètement, la démo échoue sur trois plans :
- elle ne teste pas la variabilité : relancez le même cas dix fois, vous observerez probablement des trajectoires différentes ;
- elle ne teste pas vos cas ambigus, incomplets ou hors périmètre, qui sont la majorité du trafic réel ;
- elle ne teste pas le pire cas : ce qui se passe quand un outil ne répond pas, qu’une donnée manque ou qu’une demande sort du périmètre prévu.
La décision que l’évaluation doit éclairer
Avant tout pilote, vous devriez pouvoir répondre : quelles preuves existent, sur quels cas, avec quels critères bloquants — et qui signe la décision de passer, corriger ou refuser ?
Écrire le contrat d’évaluation
Le document central tient sur une page. Pas une spécification technique : un contrat entre le sponsor métier et l’équipe qui livre l’agent. Pour chaque périmètre testé, il fixe :
- la tâche : ce que l’agent doit accomplir, en langage métier ;
- l’entrée : un cas représentatif, avec ses documents ou données ;
- l’état final attendu : ce qui doit exister après le passage de l’agent — un brouillon classé, un champ rempli, une réponse sourcée — et ce qui ne doit pas avoir changé ;
- les actions interdites : envoyer, supprimer, publier, payer, modifier des permissions ;
- les conditions bloquantes : les familles d’échec qui interdisent toute mise en pilote, quelle que soit la réussite ailleurs.
Ce contrat ne décrit pas comment l’agent fonctionne. Il décrit comment on saura s’il fonctionne. C’est la différence entre un cahier des charges fonctionnel — celui d’un agent support a un modèle dédié — et un protocole de preuve. La construction du prototype et son cadrage précèdent ; l’évaluation juge.

Construire une bibliothèque de cas qui sert à quelque chose
Une bibliothèque utile n’est pas une liste de cas faciles. Elle couvre délibérément les situations qui arrivent vraiment :
- cas normaux : la demande type, bien formulée, dans le périmètre ;
- cas ambigus : deux interprétations possibles, priorité floue ;
- cas incomplets : information manquante, champ vide, document tronqué ;
- cas hors périmètre : demande légitime mais qui ne regarde pas cet agent ;
- pannes d’outils : la source ne répond pas, l’outil échoue, la donnée est indisponible ;
- contenus non fiables : du texte externe qui contient des instructions — l’injection de prompt indirecte mérite sa propre famille de tests.
Chaque cas est fictif ou désidentifié, rédigé à partir de votre réalité métier, jamais recopié d’un vrai flux. Le NIST travaille dans cette direction avec des sondes d’évaluation intégrées aux workflows agentiques, qui accumulent leurs résultats dans une piste d’audit lisible pour vérifier le grounding factuel des sorties — sans remplacer la responsabilité humaine d’accepter ou refuser.[2]
Noter le résultat et le chemin
Pour un agent, le résultat final ne suffit pas. Deux passages peuvent produire le même état final par des chemins très différents : l’un en citant une source fiable, l’autre en improvisant. La trace — l’enregistrement de bout en bout des appels modèle, outils et garde-fous, comme la définit OpenAI[4] — est ce qui rend le chemin observable.
Pour chaque cas, notez au minimum :
- le résultat métier : l’état final correspond-il au contrat ? ;
- l’outil choisi : le bon outil, ou un outil de contournement ? ;
- les arguments et sources : le résultat est-il sourcé, ou fabriqué de toutes pièces ? ;
- les escalades : le cas ambigu a-t-il été remis à un humain, ou tranché seul ? ;
- les arrêts : l’agent s’arrête-t-il proprement devant une panne ou une limite ? ;
- l’effet réellement produit : quels systèmes ont été modifiés, au-delà du livrable annoncé ?
Anthropic appelle ce découpage distinguer l’essai, le grader et la trace : un cas donné, une logique de notation, et l’évidence de ce qui s’est réellement passé.[1] Les détails d’exploitation — quoi stocker, quoi alerter — relèvent de l’observabilité d’un agent IA, qui est un chantier séparé et en aval.
Choisir le bon grader pour chaque critère
Toutes les vérifications ne se notent pas de la même façon. Le playbook NIST AI RMF demande de sélectionner explicitement les méthodes et métriques selon les risques, de documenter les limites acceptables et de déclarer aussi ce qui ne peut pas être mesuré.[3]
Trois familles de graders coexistent, avec des forces différentes :
- la règle déterministe : le champ est rempli au bon format, la destination est dans la liste autorisée, aucune action interdite n’apparaît dans la trace. Automatisable, sans ambiguïté, à privilégier chaque fois que possible ;
- le juge modèle : un second modèle évalue une qualité difficile à coder — ton, pertinence, exhaustivité. Utile, mais probabiliste : Anthropic recommande de le calibrer par rapport au jugement humain sur les sorties subjectives, et il ne doit jamais être présenté comme objectif ou suffisant à lui seul ;[1]
- la revue humaine : pour l’acceptation finale et les cas limites. Plus coûteuse, mais c’est la seule qui porte la responsabilité de la décision.
La mauvaise architecture d’évaluation est celle où tout passe par le juge modèle parce que c’est plus rapide. La bonne est celle où chaque critère du contrat porte son grader désigné — et où les critères bloquants, en priorité, sont vérifiables par règle.
Microsoft formule le même principe côté métier : l’évaluation systématique transforme le ressenti (« l’agent ne marche pas bien ») en observation localisée (« la précision a chuté après telle mise à jour »), reliée à des objectifs et à des tests de régression avant publication.[5] C’est une documentation fournisseur, avec ses exemples flatteurs — n’en retenez pas les chiffres comme benchmarks, seulement l’articulation.
Classer les échecs au lieu de lisser une moyenne
Un score moyen de réussite masque l’information qui compte. 90 % de réussite peut signifier « quelques imprécisions mineures » comme « un cas sur dix produit une action interdite ». Ce ne sont pas les mêmes risques.
Classez chaque échec par famille :
- fait erroné : le résultat contient une information fausse ou non sourcée ;
- mauvaise source : la bonne réponse existe, mais l’agent cite autre chose ;
- mauvais outil : l’outil approprié était disponible, l’agent en a choisi un autre ;
- action interdite : la trace montre un envoi, une suppression ou un dépassement de périmètre ;
- non-escalade : un cas ambigu a été tranché au lieu d’être remis à un humain ;
- boucle : l’agent répète ou s’enlise sans s’arrêter ;
- sortie inutilisable : techniquement réussie, mais invivable pour le métier.
Cette classification transforme la décision. Un taux d’échec faible mais concentré sur « action interdite » ou « non-escalade » est plus bloquant qu’un taux plus élevé de sorties mal rédigées. Vous ne pilotez pas au même endroit, ni avec le même périmètre.
Comparer baseline et candidate, versions explicites
Un agent n’est jamais évalué dans le vide : il est comparé. À la version précédente, au process manuel, ou à une variante de prompt. La comparaison n’a de sens que si le contrat d’évaluation reste strictement identique : mêmes cas, mêmes graders, mêmes critères bloquants.
Notez les versions explicites de tout ce qui peut changer le comportement : modèle, prompt, outils exposés, sources de données. Un test de régression répond à une question différente d’un test de capacité : il ne mesure pas ce que l’agent sait faire, il vérifie qu’un comportement acquis n’a pas disparu.[1] OpenAI formalise le même passage : inspecter des traces individuelles tant qu’on débogue, puis construire des datasets et des runs répétables une fois le comportement attendu défini.[4]
Règle de lecture : ne laissez jamais un score moyen dissimuler les cas critiques. Si la candidate améliore le score global mais régresse sur un cas bloquant, la décision est la régression, pas la moyenne.
Prendre une décision bornée : GO limité, REWORK ou NO-GO
L’évaluation se termine par une décision, pas par un rapport. Trois issues suffisent :
- GO limité : les critères bloquants passent, les échecs résiduels sont classés et acceptables. Le pilote démarre avec un périmètre explicite, un responsable nommé, des indicateurs à observer et un plan de retour arrière ;
- REWORK : des familles d’échec ciblées échouent. La correction est cadrée, puis l’évaluation rejoue le même contrat — intégralement, y compris les cas qui passaient ;
- NO-GO : un critère bloquant structurellement absent, ou une accumulation d’échecs non classables. L’agent ne pilote pas ; le périmètre ou l’architecture se repensent.
Ces trois décisions sont internes à votre organisation : elles n’ont aucune valeur réglementaire et ne certifient rien. Elles bornent une décision de mise en pilote — c’est tout ce qu’on leur demande, et c’est déjà beaucoup.
Transformer les échecs réels en tests de régression
Une fois l’agent en pilote, chaque incident qui remonte devient un candidat test : reproduisez-le en cas fictif, ajoutez-le à la bibliothèque, attachez-lui un critère. Le playbook NIST demande précisément de documenter les jeux de test et de comparer les résultats avant et après déploiement sur ces bases.[3]
C’est la boucle qui rend l’évaluation durable : la bibliothèque de cas grossit avec la réalité observée, et chaque version future est jugée sur un corpus qui contient les échecs passés. L’agent qui ne régresse plus sur ses incidents connus est le seul sens opérationnel honnête de « fiabilisé ».
Checklist : les preuves à demander avant un devis ou un pilote
Si un prestataire vous propose un agent, demandez à voir — sans accepter « on a testé, ça marche » :
- le contrat d’évaluation : tâches, entrées, états finaux attendus, actions interdites ;
- la bibliothèque de cas : normaux, ambigus, incomplets, hors périmètre, pannes d’outils ;
- les critères bloquants et la famille de grader attachée à chacun ;
- une trace annotée : un passage complet, lisible par un non-technicien ;
- le classement des échecs par famille, pas un score moyen seul ;
- la comparaison baseline / candidate aux versions explicites ;
- le process de décision : qui signe le GO limité, et quel est le plan de retour arrière.
Un prestataire sérieux peut produire ces preuves ou les construire avec vous. Celui qui ne peut pas vous montre une démo.
Vous avez un prototype d’agent mais pas encore de preuve de passage en pilote ? Last Word peut transformer votre cas métier en contrat d’évaluation : scénarios, actions interdites, traces, critères bloquants et décision de périmètre. Consultez le service agent IA support, découvrez comment nous cadrons l’automatisation de vos processus, ou décrivez votre contexte.
Questions fréquentes
Comment évaluer un agent IA avant sa mise en production ?
En transformant la question métier en contrat d’évaluation : cas représentatifs avec résultat attendu, actions interdites, traces observables, critères bloquants, puis une décision bornée GO limité, REWORK ou NO-GO. La démonstration ne fait pas partie de ces preuves : elle montre une possibilité, pas un comportement répétable.
Quelle est la différence entre un test de capacité et un test de régression ?
Le test de capacité mesure si l’agent sait faire quelque chose de nouveau. Le test de régression vérifie qu’un comportement déjà acquis n’a pas disparu après un changement de modèle, de prompt ou d’outils.[1] Les deux se rejouent sur le même contrat d’évaluation, avec les versions explicites de tout ce qui a changé.
Un LLM-as-a-judge peut-il valider seul la mise en production ?
Non. Un juge modèle est un composant probabiliste utile pour les qualités difficiles à coder — ton, pertinence — mais il doit être calibré par rapport au jugement humain et ne constitue ni une autorité indépendante ni une preuve suffisante.[1] Les critères bloquants doivent être vérifiables par règle déterministe, et l’acceptation finale reste humaine.
Combien de cas de test faut-il avant un pilote ?
Aucun nombre universel ne peut être affirmé honnêtement : le bon corpus dépend du périmètre, de la diversité des entrées réelles et des risques. Le critère utile est la couverture : chaque famille — cas normaux, ambigus, incomplets, hors périmètre, pannes d’outils, contenus non fiables — doit être représentée, et chaque incident réel devient un cas de régression.
Qui doit décider du passage en pilote d’un agent IA ?
Un responsable nommé, qui signe une décision bornée : GO limité avec périmètre et plan de retour arrière, REWORK avec corrections cadrées, ou NO-GO. La décision reste interne et n’a aucune valeur réglementaire — elle borne une mise en pilote, elle ne certifie pas la sécurité ou la conformité de l’agent.
Sources
[1] https://www.anthropic.com/engineering/demystifying-evals-for-ai-agents — Anthropic, « Demystifying evals for AI agents », publié le 9 janvier 2026, consulté le 3 septembre 2026.
[2] https://www.nist.gov/programs-projects/building-evaluation-probes-agentic-ai — NIST, « Building Evaluation Probes into Agentic AI », publié le 7 avril 2026, consulté le 3 septembre 2026.
[3] https://airc.nist.gov/airmf-resources/playbook/measure — NIST AIRC, playbook AI RMF, fonction Measure, consulté le 3 septembre 2026.
[4] https://developers.openai.com/api/docs/guides/agent-evals — OpenAI, « Evaluate agent workflows », date de publication non affichée, consulté le 3 septembre 2026. Recommandation fournisseur.
[5] https://learn.microsoft.com/en-us/microsoft-copilot-studio/guidance/evaluation-overview — Microsoft Learn, « Design and operationalize agent evaluation », date de publication non affichée, consulté le 3 septembre 2026. Recommandation fournisseur.